La respuesta estaba en la página, tres párrafos demasiado tarde
Un equipo de catálogo auditó un trimestre de citas de asistentes el invierno pasado y encontró un patrón testarudo. Sus entradas aparecían mencionadas en respuestas con la suficiente frecuencia, pero solo las líneas de apertura sobrevivían al resultado final. La frase útil —la que decía con exactitud qué hacía un programa— estaba en el cuarto párrafo, detrás de una introducción sobre la categoría. El asistente ya había tomado lo que necesitaba de la parte alta y se había ido. Esa es la lógica llana que sostiene la escritura answer-first: un motor que arma una respuesta con prisa no lee la página entera antes de decidir qué cita.
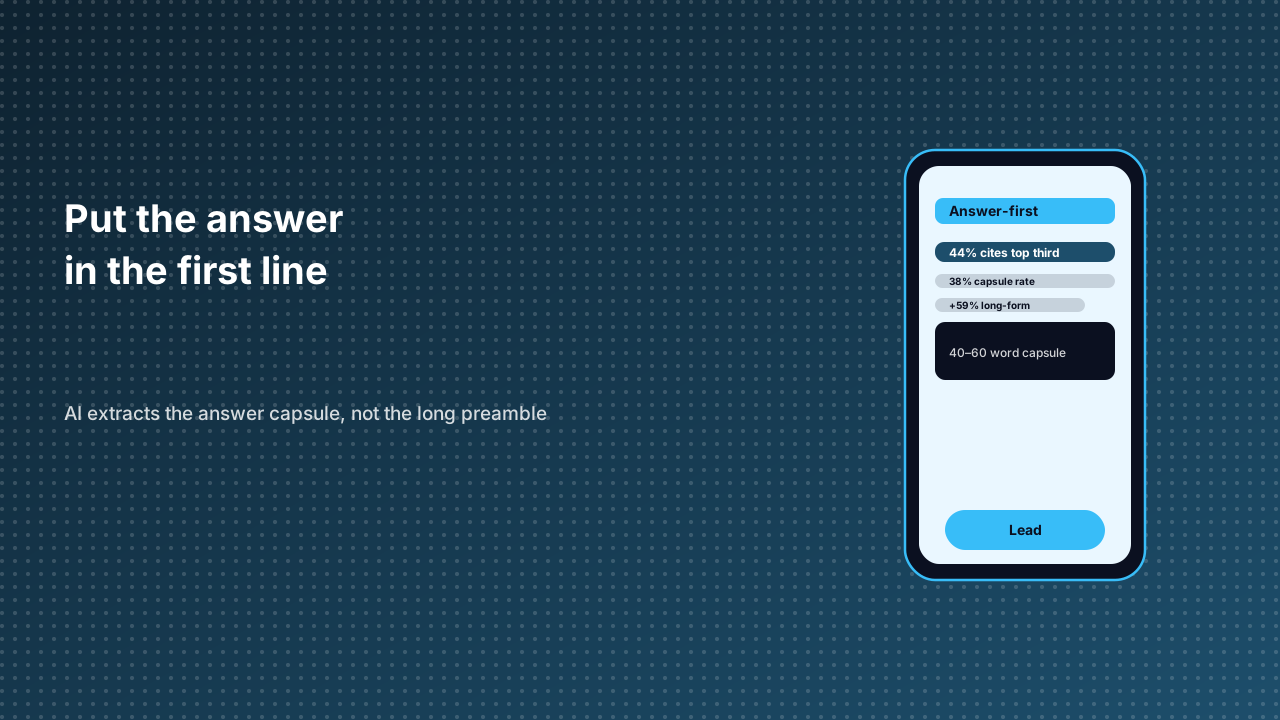
El análisis de Kevin Indig sobre 18,012 citas de ChatGPT en 1.2 millones de respuestas pone un número al patrón. El 44.2% de las citas de IA provenían del primer tercio de una página (AgentSite). La cercanía al comienzo no es una preferencia estilística; es una restricción de extracción. Una frase situada al principio sale más barato de recuperar para un sistema y es más seguro de atribuir, así que acaba recuperada.
Por eso buena parte de los consejos actuales se reducen a un solo movimiento: convertir el encabezado en la pregunta que una persona formularía de verdad y responderla de inmediato. En esa misma línea de análisis, la estructura de título-pregunta como H2 más una cápsula de respuesta de 40–60 palabras alcanzó una tasa de citación del 38% frente a la línea de base. La entrada de catálogo deja de ser un folleto y se convierte en una unidad citable: un dato que un motor puede repetir sin visitar la página.
Lo que los estudios midieron realmente
Cinco hallazgos, cinco reglas de medición distintas y varias cifras fáciles de leer en exceso.
| Estudio | Qué se midió | Cifra principal | La letra pequeña |
|---|---|---|---|
| Estudio GEO de Princeton / Georgia Tech (KDD 2024, n=10,000) | Aumento de visibilidad en respuestas generativas; único experimento controlado revisado por pares en este ámbito | Hasta +40% de visibilidad; estadísticas con fuentes +40%, citar fuentes fiables +37%, fluidez +15%, relleno de palabras clave +4% | Las tácticas se separan mucho: el relleno apenas mueve la aguja |
| Kevin Indig, 2025 | 18,012 citas de ChatGPT en 1.2 millones de respuestas | 44.2% de citas del primer tercio; título-pregunta H2 + cápsula de 40–60 palabras en 38% frente a línea de base | Observacional, no un ensayo controlado |
| AirOps, 2025 | Forma de los pasajes en páginas citadas por ChatGPT frente al primer resultado de Google | 13.75 pasajes con listas por página citada frente a menos de uno; 79% usan listas HTML contra 28.6% | Asociación, no una receta |
| Estudios del sector (formato) | FAQ schema, jerarquía de encabezados, número de tablas | Páginas con FAQ schema 3.2 veces más probables en AI Overviews; H1>H2>H3 limpio 3.2 veces la tasa de cita; 3+ tablas +25.7% de citas | Investigación sectorial, métodos mezclados: solo orientativo |
| SE Ranking, 2025-11 (10,000+ páginas) | Longitud del artículo y de las secciones frente a la citación por ChatGPT | Artículos de 2,900+ palabras citados 59% más que los de menos de 800; secciones de 120–180 palabras 70% más que las de menos de 50 | Un motor, un índice |
Cuarenta a sesenta palabras no son una ley física
La cifra se repite como si fuera física. No lo es. La cápsula de 40–60 palabras es una convención de trabajo entre profesionales, más o menos el tamaño que cabe en una caja de respuesta, y nada más. Lo que el estudio GEO de Princeton/Georgia Tech estableció de verdad —el único experimento controlado revisado por pares aquí, en KDD 2024 con n=10,000— es que las tácticas difieren enormemente. Las estadísticas con fuentes sumaron 40% de visibilidad, citar fuentes fiables 37%, la fluidez 15%, mientras que el relleno de palabras clave apenas logró 4% (spawned.com). La lección no es alcanzar un recuento de palabras. Es dar al extractor algo verdadero y con fuente que pueda llevarse intacto.
Y aquí está el intercambio incómodo. La misma franqueza que hace citable un pasaje puede hacer desagradable de leer un artículo. Una página armada enteramente con pares de pregunta y cápsula se lee como una cola de incidencias: precisa, escaneable y curiosamente sin alma. Los lectores siguen siendo personas. Llegan con preguntas a medio formar y necesitan un párrafo que conecte la respuesta con una situación antes de confiar en ella. Conviene construir la parte alta para la máquina y luego ganar al lector en los párrafos de abajo. Enterrar la respuesta falla a la máquina; aplanarlo todo en cápsulas falla a la persona. La disciplina consiste en saber qué parte de la página hace qué trabajo.
Las cifras de Indig y AirOps también son observacionales. Las páginas que abren con una respuesta rotunda bien pueden venir de equipos que además hacen bien todo lo demás. La estructura es barata de adoptar y apenas tiene inconvenientes, así que merece la pena; pero no es una garantía, y quien la venda como tal está omitiendo la metodología.
Reescribir las entradas del catálogo para la extracción
En un catálogo de mini-programas el cambio práctico es mecánico. Cada entrada se convierte en una pregunta que alguien formularía de verdad, respondida en un párrafo ajustado antes de que empiece la descripción larga. Las listas sustituyen a la prosa siempre que varios datos conviven: AirOps halló que las páginas citadas por ChatGPT llevaban 13.75 pasajes con listas de media, frente a menos de uno en el primer resultado de Google, y que el 79% usaba listas HTML contra el 28.6% (Aruntastic). Las secciones de longitud media, entre 120 y 180 palabras, superaron a las muy cortas, y las páginas comparativas con tres o más tablas recibieron 25.7% más de citas en investigación sectorial —una cifra orientativa, no un resultado controlado (AEO Expert). La longitud del artículo pesa en el mismo sentido: el índice de 10,000+ páginas de SE Ranking de 2025-11 encontró que las piezas de más de 2,900 palabras se citaban 59% más que las de menos de 800.
Nada de eso significa rellenar hasta un umbral. La longitud ayuda porque ofrece más superficies citables a un motor, no porque el recuento de palabras sea en sí un factor de posicionamiento.
Una superficie gobernada
El objetivo no es escribir para máquinas a costa de los lectores. Es hacer que el primer párrafo haga dos trabajos a la vez: responder la pregunta con la claridad suficiente para ser citado y abrir una descripción que alguien quiera seguir leyendo. El catálogo abierto y el entorno de ejecución compartido de CrossMiniApp dan a un servicio una superficie gobernada donde esa entrada answer-first puede leerse, citarse y lanzarse desde cualquier lugar donde se forme la respuesta. Los recuentos de palabras entran y salen de moda. Una respuesta clara al principio es lo que permanece.