

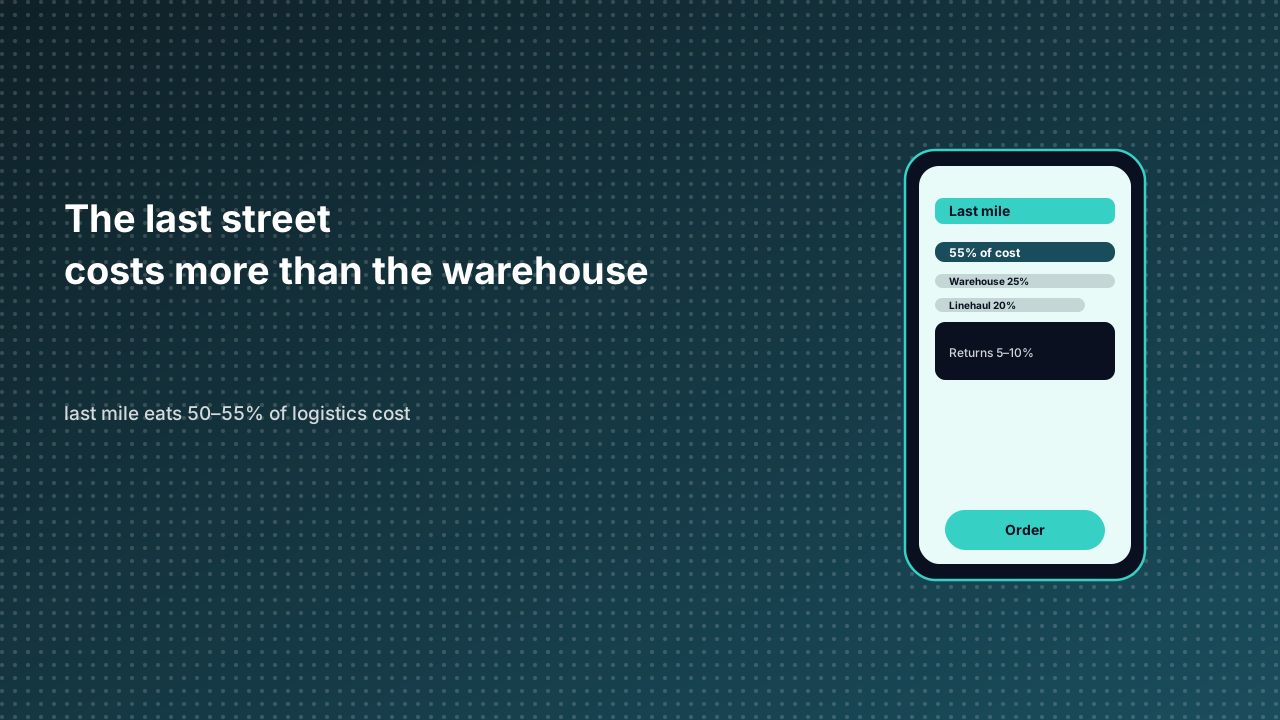
Un paquete que descansa en un almacén automatizado y bien ordenado ya ha consumido la parte barata de su viaje. McKinsey sitúa la logística total en torno al 12–20% de los ingresos del comercio electrónico, y dentro de ese presupuesto el último tramo, desde un nodo local hasta la puerta de casa, absorbe más de la mitad del coste de fulfillment en muchos mercados. Un desglose de costes asigna a la entrega de última milla el 50–55% del total, al almacenamiento el 20–25%, al transporte de larga distancia el 15–20% y a la gestión de devoluciones el 5–10%. El segmento más caro es también el que tiene menos densidad y más juicio humano por parada.
La razón es aritmética, no mala gestión. Las direcciones residenciales se reparten por una geografía amplia, las franjas de entrega dependen de que alguien esté en casa, los intentos fallidos exigen un segundo viaje y cada paquete carga con una parte del combustible y de la mano de obra del repartidor que una ruta comercial consolidada repartiría entre decenas de entregas. La demanda rural lo empeora: la baja densidad de pedidos y las largas distancias hacen estructuralmente ineficiente la entrega rápida, y sin embargo el marketing nacional promete el mismo plazo en todas partes. Los núcleos urbanos se inclinan al otro lado, donde la congestión encarece el coste pero la concentración vuelve racional la entrega el mismo día. La geografía, no la política, fija la promesa viable.
| Etapa del fulfillment | Cuota del coste logístico |
|---|---|
| Entrega de última milla | 50–55% |
| Almacenamiento y operaciones de fulfillment | 20–25% |
| Transporte de larga distancia | 15–20% |
| Gestión de devoluciones | 5–10% |
Las expectativas del consumidor han convertido esta línea de coste en una línea de ingresos. Más del 60% de los compradores online consideran la velocidad de entrega un factor principal a la hora de elegir minorista, y el abandono del carrito supera el 70%, con costes extra y entregas lentas entre las causas más citadas. Las consecuencias operativas son tajantes: el 91% de los clientes revisa activamente el seguimiento, WISMO —dónde está mi pedido— genera entre el 30–40% del volumen de soporte, y hasta el 30% de los compradores abandona una marca tras una sola entrega fallida o incorrecta. Después de dos o tres pedidos malos, la cifra sube al 81%. Una entrega más barata que pierde al comprador no es un ahorro.
La respuesta habitual es acercar el inventario a la demanda: nodos regionales, fulfillment desde tiendas, microcentros y optimización de rutas que recorta entre un 10–15% los kilómetros recorridos. Todo eso funciona, y todo eso exige capital. Existe una capa más barata a la que se presta menos atención: reducir el número de viajes fallidos, inciertos e innecesarios mejorando la propia superficie de pedido.
Aquí es donde el pedido embebido se gana su sitio. Un mini-programa dentro de una app anfitriona no es un almacén mejor; es un mejor front end para el mismo almacén. Puede fijar la ubicación de entrega a partir de la cuenta del host, en lugar de una dirección mal escrita; mostrar una franja horaria realista antes del checkout y no después del pago; ofrecer un punto de recogida o una taquilla cuando la dirección tiene historial de intentos fallidos; y enviar un aviso proactivo de retraso antes de que exista el ticket de soporte. La prueba fotográfica de recepción y la reprogramación con un toque zanjan la disputa de «nunca llegó», que de otro modo genera una segunda entrega gratuita. Cada una de esas medidas significa unos puntos más de densidad o un viaje evitado, y los reintentos son el tipo más caro de viaje.
Las devoluciones entran en el mismo cálculo. La logística inversa se lleva el 5–10% del presupuesto, y una etiqueta prepagada más una cola de inspección convierten un coste de salida en dos. Una superficie embebida puede orientar hacia un cambio en lugar de un reembolso, mostrar al comprador el estado de la disposición y encaminar el artículo al nodo más cercano que realmente pueda revenderlo. No arregla una red deficiente, pero evita que el front end fabrique viajes de devolución evitables.
Dos cautelas mantienen esto honesto. Primero, la velocidad es una norma contextual y no una demanda universal: la fiabilidad y unos plazos transparentes suelen importar tanto como la rapidez bruta, y los compradores aceptan franjas más largas cuando se comunican y se cumplen. Un runtime que promete entrega el mismo día en todas partes importa el problema de coste rural a todo el catálogo. Segundo, el coste de la última milla es en parte un coste de carbono —entre el 40–50% de las emisiones de la cadena de suministro en algunas estimaciones—, así que las mejoras de densidad y la consolidación de franjas pagan dos veces.
La conclusión práctica para una plataforma anfitriona es tratar los datos de fulfillment como una entrada de la experiencia de pedido, no como un informe que se imprime después. Alimentar el mini-programa, en el momento en que el comprador se compromete, con la calidad de la dirección, el éxito histórico de entrega por zona y los horarios de corte reales. Así, un comerciante del catálogo anuncia una promesa que la red puede cumplir y conserva el margen que una promesa fallida habría consumido. El almacén sigue donde está; las promesas se vuelven más inteligentes.
Fuentes
- De almacenes nacionales a nodos locales — cuota logística según McKinsey y desglose del coste de fulfillment.
- Cómo funciona el envío en comercio electrónico — factores de coste de última milla, seguimiento y abandono tras una entrega fallida.
- Eficiencia y gestión de costes en el fulfillment electrónico — tiempo de recorrido del preparador y flete de salida.
- Entrega de última milla y satisfacción del cliente — cifras de coste y satisfacción de 2025.


