

Un operador abre el panel un lunes por la mañana y encuentra una rendija delgada de referencias procedentes de superficies de asistente. El rastreador de posiciones no muestra ningún movimiento. Sin embargo, los tickets de soporte mencionan la mini app por su nombre, y las personas describen haber llegado a través de una conversación y no de una página de resultados. Nada en el informe de posiciones había anticipado aquello.
Esa distancia es la historia real del último año. La búsqueda se transforma de una lista de enlaces en una respuesta generada, y el descubrimiento se transforma de una posición en una cita. Un asistente que recomienda una mini app no la ha posicionado en ningún sentido conocido. La ha seleccionado de entre un conjunto de candidatos y la ha colocado dentro de una frase. Ser seleccionado funciona con mecanismos distintos a ser posicionado, y la mayoría de los manuales de distribución sigue suponiendo el juego antiguo.
Las curvas no coinciden entre sí
La magnitud del cambio aparece en la cobertura antes que en los clics. Semrush analizó más de diez millones de palabras clave y encontró AI Overviews en aproximadamente el 6.5% de ellas en enero de 2025, con un pico cercano al 25% en julio y una caída por debajo del 16% en noviembre (según informa Inc.). Una curva que sube, se pasa de largo y retrocede parcialmente no es la huella de una moda que se apaga. Se parece más a un sistema que encuentra su nivel. El pico de julio copió los titulares. El suelo de noviembre es la cifra que merece seguimiento, porque incluso en el punto más bajo aproximadamente una consulta de cada seis seguía produciendo una respuesta generada en lugar de una pila neutra de enlaces.
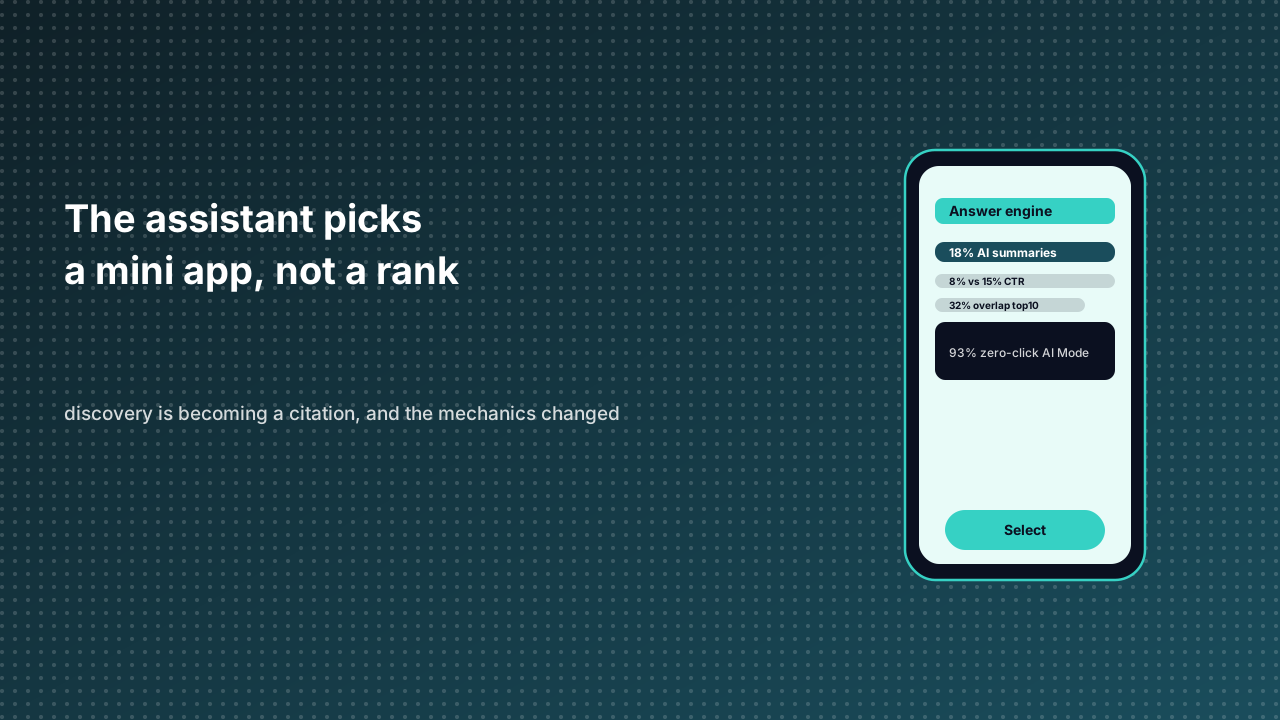
Pew Research Center puso una escala humana a ese suelo. En una encuesta de 900 adultos estadounidenses que abarcó 68,879 búsquedas (Pew Research Center), aproximadamente el 18% de las búsquedas produjeron un resumen de IA. Con un resumen presente, los clics hacia resultados tradicionales cayeron al 8%, frente al 15% sin él. Las sesiones que terminaron sin visitar ningún sitio web subieron al 26%, contra el 16%. Las consultas más largas generaban resúmenes con mucha más frecuencia, hasta alcanzar el 53% en búsquedas de diez palabras o más. El patrón es tosco: cuanto más específica es la pregunta, más probable es que se ensamble una respuesta para la persona en lugar de ir a buscarla en una lista.
Las cifras de zero-click necesitan una advertencia sanitaria, porque lo que circula no mide lo mismo. En AI Mode de Google, la tasa de zero-click es del 93% a nivel de sesión, frente al 60% de la búsqueda tradicional y al 83% de las consultas que llevan un AI Overview. Un panel multidispositivo de Semrush sitúa la cuota más amplia de zero-click cerca del 59.7% en marzo de 2025, contra el 44.2% un año antes, con un denominador distinto, una mezcla de dispositivos distinta y una idea distinta de qué cuenta como clic. La conclusión defendible es que el zero-click es alto y va en aumento bajo toda definición razonable, mientras que el porcentaje exacto se mueve según la superficie medida. El 93% pertenece específicamente a las sesiones de AI Mode; es una afirmación sobre esa superficie, no sobre toda la búsqueda. A finales de 2025, AI Mode había alcanzado 75 millones de usuarios activos diarios y más de mil millones de consultas al mes.
Más importante que la pérdida de clics es lo que hay dentro de la respuesta. En AI Mode, solo el 32% de las URL citadas procedían de los diez primeros resultados de Google. Esa sola cifra desmonta la suposición cómoda de que posicionarse bien y ser citado son la misma tarea. Dos tercios de las fuentes que eligió el asistente estaban fuera del top ten. Un equipo que optimiza solo para los enlaces azules está refinando una lista que el motor de respuesta ignora en gran medida.
El análisis de Seer Interactive del tercer trimestre de 2025 encontró que las marcas citadas en AI Overviews tenían tasas de clic orgánico un 35% más altas (0.70% contra 0.52%) y tasas de clic en anuncios pagados un 91% más altas. Son asociaciones. Llamarlas efectos sobrestimaría lo que muestra el estudio, porque la cita y los clics viajan juntos en parte porque ambos derivan de la demanda de marca existente. Leer el 35% como un dial que girar es como empieza el reporting de GEO a parecerse a la alquimia. El trabajo de optimización generativa de Princeton (registro de publicación), presentado en KDD, encontró que las técnicas de GEO podían elevar la visibilidad en respuestas de motores generativos hasta un 40%. Ese es un techo observado en condiciones controladas, y cualquier catálogo que lo trate como previsión está adivinando. El estudio de tráfico de IA de Ahrefs sirve aquí de contrapeso útil, porque rastrea lo delgadas que siguen siendo estas referencias en analítica ordinaria, que es justamente por lo que el reporting basado en posiciones no las ve.
Una tabla con la que vale la pena discutir
| Pregunta del operador | Manual basado en posiciones | Realidad del motor de respuesta |
|---|---|---|
| ¿Dónde ocurre el descubrimiento? | Una página posicionada con diez enlaces | Una frase generada que nombra unas pocas fuentes |
| ¿Qué cuenta como victoria? | Posición y tasa de clic | Ser citado o recomendado dentro de la respuesta |
| ¿Qué tan concurrido es el conjunto? | Diez huecos en la primera página | Un grupo fluido, con solo un 32% de solapamiento con el top ten |
| ¿Siguen los clics a la visibilidad? | Se trata como lineal | Las marcas citadas muestran mayor CTR, solo como correlación |
| ¿Qué tan rápido se mueve? | Estacional y bastante estable | La cobertura osciló del 6.5% al 25% y volvió a bajar del 16% en un año |
La tentación de corregir en exceso
Existe una fuerte atracción a tratar todo esto como permiso para reescribir cada entrada del catálogo pensando en las máquinas. Eso es una corrección excesiva, y suele producir la papilla de palabras clave que los motores de respuesta están diseñados para saltarse. El movimiento útil es más estrecho y menos glamuroso: hacer que la entidad sea inequívoca. Un identificador estable, una descripción honesta, una relación clara entre el servicio y su categoría y una apertura centrada en la respuesta en cada entrada dan a una máquina algo que puede citar sin adivinar. La estructura importa, pero la estructura solo entrega el producto; el producto es una entidad clara y fiable. El verdadero compromiso es que escribir con la respuesta primero puede leerse como brusco para un público humano. Los equipos que se preocupan por ambos públicos tienen que aceptar un poco de sequedad a cambio de ser seleccionables. Ese es un precio que vale la pena pagar por el descubrimiento, pero conviene pagarlo deliberadamente, no convirtiendo el catálogo en un muro de preguntas frecuentes.
Dónde ayuda un catálogo abierto
Aquí es donde un catálogo abierto gana su sustento. Una máquina no puede recomendar lo que no puede analizar, y no puede confiar en un registro que cambia de forma de un anfitrión a otro. Un directorio compartido y legible por máquina da a cada mini app una descripción canónica que cualquier asistente puede leer, comparar y citar, mientras que un runtime compartido asegura que lo que se recomienda sea realmente abrible esté donde esté el anfitrión. El proyecto Cross Mini App trabaja en esa combinación de catálogo abierto y runtime común, porque ser elegido por un motor de respuesta solo compensa si la recomendación aterriza en una superficie que funciona. La próxima batalla de distribución no se librará por la posición uno. Se librará por qué registros son lo bastante claros como para nombrarlos en voz alta.


