

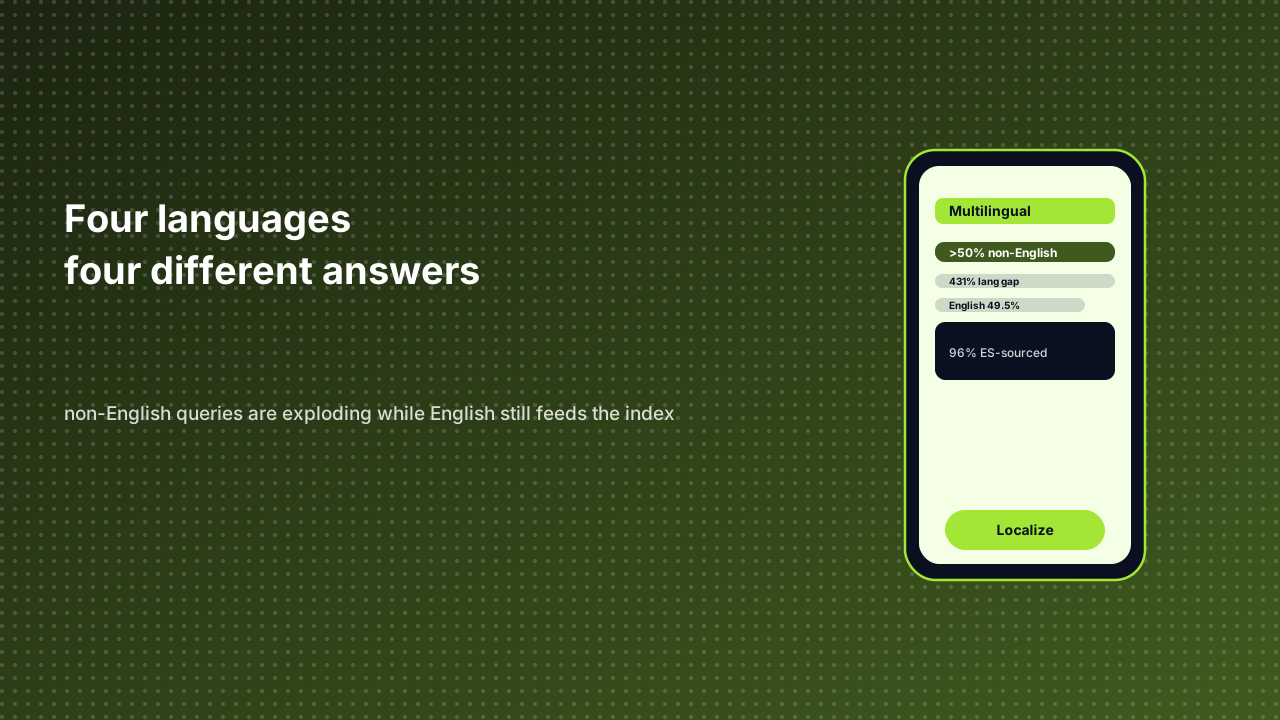
Una consulta en español dentro de los AI Overviews de Google devolvió 17.094 citas de un sitio que nunca había sido traducido al español. El mismo sitio cosechó 2.810 citas en consultas en inglés: una brecha del 431%. La cifra sale del análisis de Weglot sobre más de 1,3 millones de citas, una investigación de proveedor con un interés comercial evidente, así que conviene leerla como una señal potente y no como un punto de referencia neutral. Dicho sin rodeos: el motor de respuesta siguió buscando en español aunque la página se negara a hablar español.
Esa asimetría resume en una línea toda la situación del GEO multilingüe. Los asistentes responden cada vez más en el idioma de la pregunta. La recuperación que sostiene esas respuestas sigue siendo, en una medida sorprendente, una operación en inglés. La demanda y la oferta rara vez se desalinean con tanta limpieza, y en ese desajuste es donde los responsables de un catálogo pierden visibilidad o encuentran una ventaja.
El informe Signals de OpenAI, fechado el 30 de junio de 2026, puso el cambio de la demanda en cifras sencillas: más de la mitad de los usuarios activos con cuenta personal de ChatGPT usan principalmente un idioma distinto del inglés. El español, el portugués y el árabe lideraban esa lista, mientras que el uzbeko, el kazajo y el birmano crecían más rápido. Es un proveedor describiendo su propio producto, así que las cuotas exactas merecen cautela, pero la dirección pone fin a la costumbre de tratar la búsqueda con IA como sinónimo de búsqueda en inglés. El usuario habitual de un asistente ya no habla inglés, y eso cambia para qué sirve un catálogo.
Peec AI observó más de 10 millones de prompts y unos 20 millones de fan-outs en febrero de 2026. Cada sesión en un idioma no inglés de esa muestra contenía al menos una subbúsqueda en inglés; casi el 78% incorporó investigación adicional en inglés; el 43% de los pasos de investigación ocurrió en páginas en inglés. El cambio de idioma fue mayor en turco, con un 94%, y menor en español, con un 66%. Datos observacionales, no un experimento controlado, y sin embargo el patrón es terco: la respuesta llega en el idioma local, mientras que las pruebas que la sostienen casi nunca lo son.
La oferta cuenta la otra mitad. W3Techs midió el idioma de contenido conocido de los sitios web el 12 de septiembre de 2026 y encontró inglés en un 49,5%, español en un 6,0% y portugués en un 4,1%. El inglés está casi ocho veces por encima del español. Millones de personas preguntan en español, portugués o árabe y reciben una web que publica de forma abrumadora en inglés; el asistente tiene que tender ese puente en cada respuesta.
Lo mismo, preguntado en cuatro idiomas, rara vez devuelve la misma respuesta. Una consulta en español puede citar un diario mexicano, la misma en portugués un foro brasileño, y en inglés volver a la Wikipedia inglesa y a medios anglosajones. Para quien gestiona un catálogo no es una tendencia abstracta, sino un sesgo visible a diario: el contenido preparado con cuidado aparece en un solo idioma y desaparece al cambiar de lengua.
| Señal | Qué se midió realmente | Qué implica para un catálogo |
|---|---|---|
| Análisis de Weglot (1,3M+ citas) | Citas en consultas en español frente a inglés en sitios sin traducir | 17.094 frente a 2.810, brecha del 431%, dato de proveedor |
| Signals de OpenAI (30/06/2026) | Idioma principal de usuarios activos con cuenta personal | Más de la mitad en otros idiomas; español, portugués y árabe al frente |
| Observación de Peec AI (02/2026) | 10M+ prompts, 20M+ fan-outs | Cada sesión no inglesa incluye una subbúsqueda en inglés; 43% de pasos en páginas inglesas |
| Estudio arXiv (6 chatbots, 12.600 instancias) | Precisión de selección múltiple por idioma y fuentes citadas | Hindi 79% frente a 89–91%; Wikipedia inglesa más citada que noticias indias |
| W3Techs (12/09/2026) | Idioma de contenido conocido de los sitios | Inglés 49,5%, español 6,0%, portugués 4,1% |
Traducir, sin más, es un foso débil. El artículo de arXiv de la cuarta fila evaluó seis chatbots comerciales con 2.100 preguntas y 12.600 instancias. El mejor sistema superó el 90% de acierto en selección múltiple en conjunto, pero todos los modelos cayeron al 79% en hindi frente al 89–91% del resto, y recurrieron a la Wikipedia inglesa más que a cualquier medio de noticias indio. Más del 70% de los errores fueron fallos de recuperación, no de razonamiento. Ese detalle pesa: una página escrita en el idioma correcto sigue sin poder citarse si el recuperador nunca la saca a la luz. Las ganancias que Weglot informa —hasta un +327% en visibilidad en inglés y un +24% en citas totales después de traducir— son alentadoras, y el 96% de las citas de AI Overview en consultas localizadas de México procedían de fuentes en español. Pero son mediciones de un proveedor sobre su propia cartera de clientes, y la relación es correlación, no una prueba de que traducir una página provoque más citas. Una lectura prudente conserva la oportunidad y descarta la magia.
El movimiento práctico, por tanto, es más estrecho y más durable que traducirlo todo. Publicar cada versión idiomática como una entrada de primera clase, con sus propios metadatos etiquetados por idioma y su propia estructura limpia, y después comprobar si los motores de respuesta la citan realmente. El catálogo en cuatro idiomas que mantiene Cross Mini App es un ejemplo pequeño de esa apuesta: cuatro superficies recuperables por separado en lugar de una página en inglés con tres traducciones pegadas. Sobre un entorno de ejecución compartido, esas entradas cargan lo bastante rápido para ser leídas además de rastreadas. En un mercado donde la pregunta es local y la recuperación es global, tener la respuesta ya escrita en el idioma local es lo más parecido a un foso que un catálogo puede poseer.
Fuentes
- Deepsmith — el giro mayoritario no inglés de la búsqueda con IA — recopilación de los hallazgos de OpenAI Signals y Peec AI citados arriba.
- Weglot — búsqueda con IA e idioma — análisis de proveedor sobre 1,3 millones de citas y resultados de traducción.
- arXiv — evaluación multilingüe de chatbots — seis chatbots comerciales, 2.100 preguntas, 12.600 instancias.
- W3Techs — distribución del idioma de contenido — medición de la cuota de idiomas en sitios con contenido conocido.


