El experimento que la gente quiso repetir
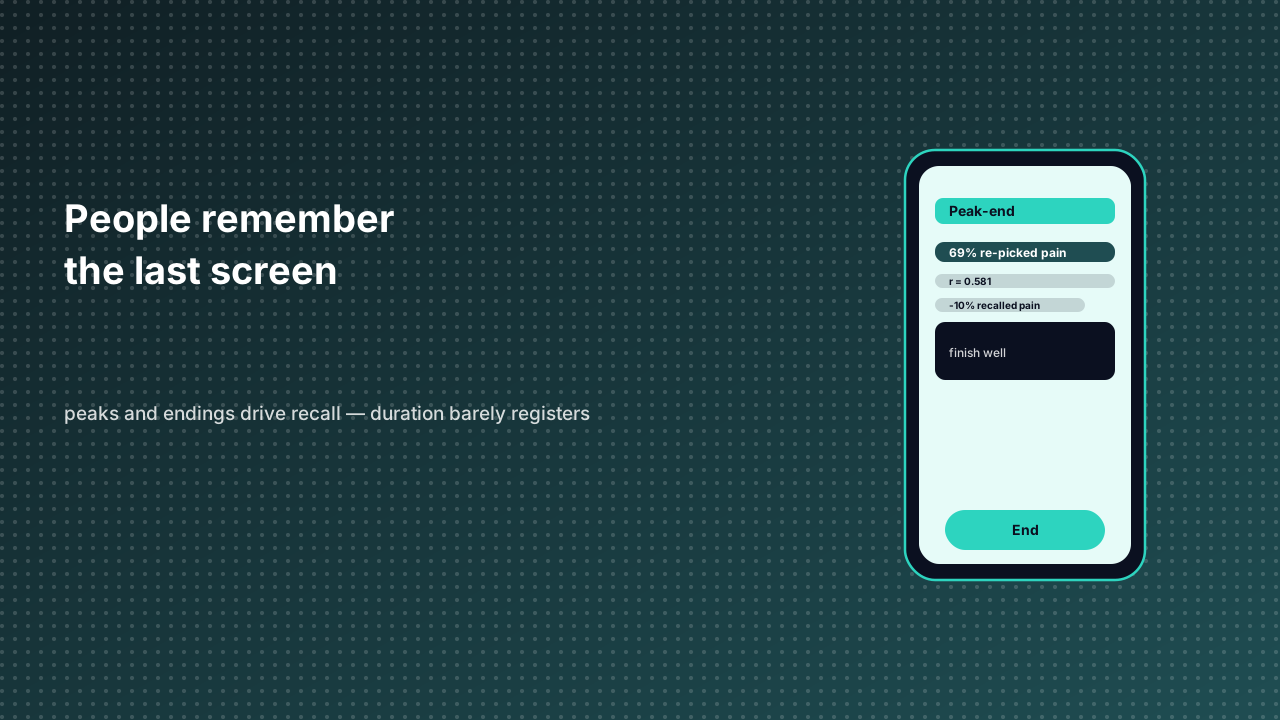
En 1993, Kahneman, Fredrickson, Schreiber y Redelmeier publicaron un hallazgo que todavía suena a error de imprenta. Los participantes sumergían una mano en agua a 14 °C durante 60 segundos y repetían la prueba en otra condición: 60 segundos a 14 °C seguidos de 30 segundos mientras el agua se templaba hasta 15 °C. La segunda prueba era objetivamente peor —treinta segundos más de malestar—. Aun así, 22 de los 32 participantes, alrededor del 69%, dijeron que preferían repetir la versión más larga. Los momentos fríos eran idénticos. Solo cambiaba el final.
Los equipos suelen evaluar un flujo con promedios: satisfacción media, tiempo medio por tarea, abandono medio, como si sumar cada segundo equivaliera a medir la experiencia. El resultado del agua fría resulta extraño justo porque ese cálculo por defecto es erróneo. La memoria no se comporta como una hoja de cálculo.
Lo que dice realmente la evidencia
| Evidencia | Escenario y muestra | Resultado que importa | Límite |
|---|---|---|---|
| Experimento del agua fría (1993) | 32 participantes, dos pruebas de inmersión | 22 eligieron la prueba más larga con un final más templado | Dolor de laboratorio, en segundos; no es un recorrido de producto |
| Ensayo de colonoscopias (2003) | 682 pacientes, aleatorizados, un minuto más de calma al final | dolor recordado 10% menor, disposición a repetir 10% mayor | Otra versión usa escala de 10 puntos, 4,4 frente a 4,9: no son intercambiables |
| Metaanálisis pico-final (2022) | 174 tamaños del efecto en varios dominios | r = 0,581 (IC 95% 0,487–0,661); efecto de la duración casi nulo | Tendencia media, no garantía por sesión |
| Estudio de procedimientos repetidos (1996) | 154 colonoscopias y 133 litotripsias | duración y valoración global, r = 0,03 | Antiguo y estrecho; conviene usarlo como contraste |
| Datos de recorrido (2025) | 126.425 visitantes, 3.376 experiencias, 522 marcas | NPS mediano 97 frente a 82 entre niveles alto y bajo | Correlación, no causalidad |
Por qué la última pantalla carga con toda la memoria
El ensayo de colonoscopias de 2003 es el hallazgo que mejor se traduce a términos de producto. Los investigadores dieron a 682 pacientes un minuto adicional de mayor calma al terminar el procedimiento. El dolor recordado bajó alrededor del 10% y la disposición a volver subió otro 10%. La duración total no cambió de un modo que explique ese desplazamiento; lo que cambió fue cómo se sentía el tramo final. Un estudio de 1996 con 154 colonoscopias y 133 litotripsias ya había encontrado una correlación de apenas r = 0,03 entre duración y valoración global. En 2022, Alaybek, Dalal y colaboradores reunieron 174 tamaños del efecto y situaron la correlación pico-final en r = 0,581 (IC 95% 0,487–0,661), más fuerte que el inicio, el valle o la tendencia, con un efecto de duración prácticamente nulo.
Para un miniprograma, esto es una instrucción de diseño disfrazada de resultado psicológico. La confirmación posterior al pago, el recibo, el estado de «completado» y la animación de salida pesan más en el recuerdo de lo que pesa su parte de la sesión. Un flujo puede ser accidentado al principio y lento en el centro, y sin embargo la historia que la gente cuenta después suena mejor que cualquier promedio de sus partes, siempre que el pico sea nítido y el cierre esté limpio. Al revés también es cierto: un titubeo en el desenlace, un mensaje de error ambiguo, puede borrar cuarenta segundos de funcionamiento suave.
La reserva
Aquí la historia se incomoda. La negligencia de la duración es un hallazgo sobre la memoria, no sobre el coste. Un flujo que desperdicia cuatro minutos sigue desperdiciando cuatro minutos: los tickets de soporte, los carritos abandonados y la batería consumida no desaparecen porque la última pantalla sea bonita. El metaanálisis describe una tendencia media; no promete que cada usuario, en cada sesión, codifique el final del mismo modo.
Los datos de recorrido son más débiles todavía y merecen honestidad. El estudio longitudinal de AnyRoad de 2025 cubrió 126.425 visitantes, 3.376 experiencias y 522 marcas: los visitantes nuevos que se convirtieron en promotores registraron una conversión del 61%, frente al 16% de los que se volvieron detractores, y los niveles de experiencia más alto y más bajo mostraron una mediana de NPS de 97 y 82 (p < 0,001). Son asociaciones, no efectos: el estudio no asignó a nadie a un final malo para observar qué ocurría. Un análisis de recorrido de Assurant, sin año indicado en la fuente, informó de asociaciones y no de efectos: el 88% de los promotores iniciales seguía siéndolo al terminar, mientras que solo el 50% de los detractores iniciales permanecía insatisfecho y el 30% se convertía en promotor; los detractores finales abandonaron hasta cinco puntos porcentuales más en noventa días. Bien leído, eso va en ambos sentidos: el final importa, pero un mal momento inicial no es una condena permanente.
La tentación es tratar la investigación como permiso para pulir el desenlace y descuidar el tramo medio. Es un mal intercambio. Una pantalla de confeti sobre un pago roto solo compra una historia algo mejor sobre un producto peor. La asignación defendible es hacer real el pico, dejar limpio el cierre, levantar la tabla más corta del tramo medio hasta que deje de llamar la atención y dejar de alimentar el promedio.
Dónde concentrar el esfuerzo
El movimiento práctico es presupuestar de forma deliberadamente desigual. Marcar los dos o tres picos de una sesión —el momento de mayor esfuerzo, el de mayor valor— y después marcar los últimos diez segundos. Dar al final un trabajo real: decir qué ocurrió, confirmar qué quedó guardado y facilitar la salida. Si un paso no se puede arreglar en este ciclo, al menos procurar que no sea lo último que alguien ve.
Hay un detalle fácil de pasar por alto: el final no es solo una pantalla, es un trecho de tiempo. Que el recibo permanezca el suficiente para leerse, que el estado de éxito muestre los campos que importan, que la salida pida o no una segunda confirmación: cada una de esas decisiones reescribe el peso de los últimos segundos. Tratarlas como un único diseño de cierre y no como una cadena de redirecciones por defecto sale barato, y la recompensa se instala en la memoria.
En un catálogo abierto, ese final es infraestructura compartida. Un mismo miniprograma puede ejecutarse dentro de varias aplicaciones anfitrionas, y el cierre es justo donde la confianza del anfitrión y la reputación del servicio se encuentran. Un runtime compartido da al equipo un único lugar donde definir ese contrato de cierre —confirmación, recibo, salida— para que la última pantalla se comporte igual esté donde esté integrada. CrossMiniApp se construyó en torno a esa idea: el recuerdo de una sesión se escribe en su final, y en un catálogo distribuido el final no debería quedar al azar.