A resposta estava na página, três parágrafos tarde demais
Uma equipe de catálogo auditou um trimestre de citações de assistentes no inverno passado e encontrou um padrão teimoso. Suas entradas apareciam citadas em respostas com frequência suficiente, mas só as linhas de abertura sobreviviam ao resultado final. A frase útil —a que dizia exatamente o que um programa fazia— ficava no quarto parágrafo, atrás de uma introdução sobre a categoria. O assistente já tinha pegado o que precisava do topo e ido embora. Essa é a lógica singela por trás da escrita answer-first: um motor que monta uma resposta com pressa não lê a página inteira antes de decidir o que citar.
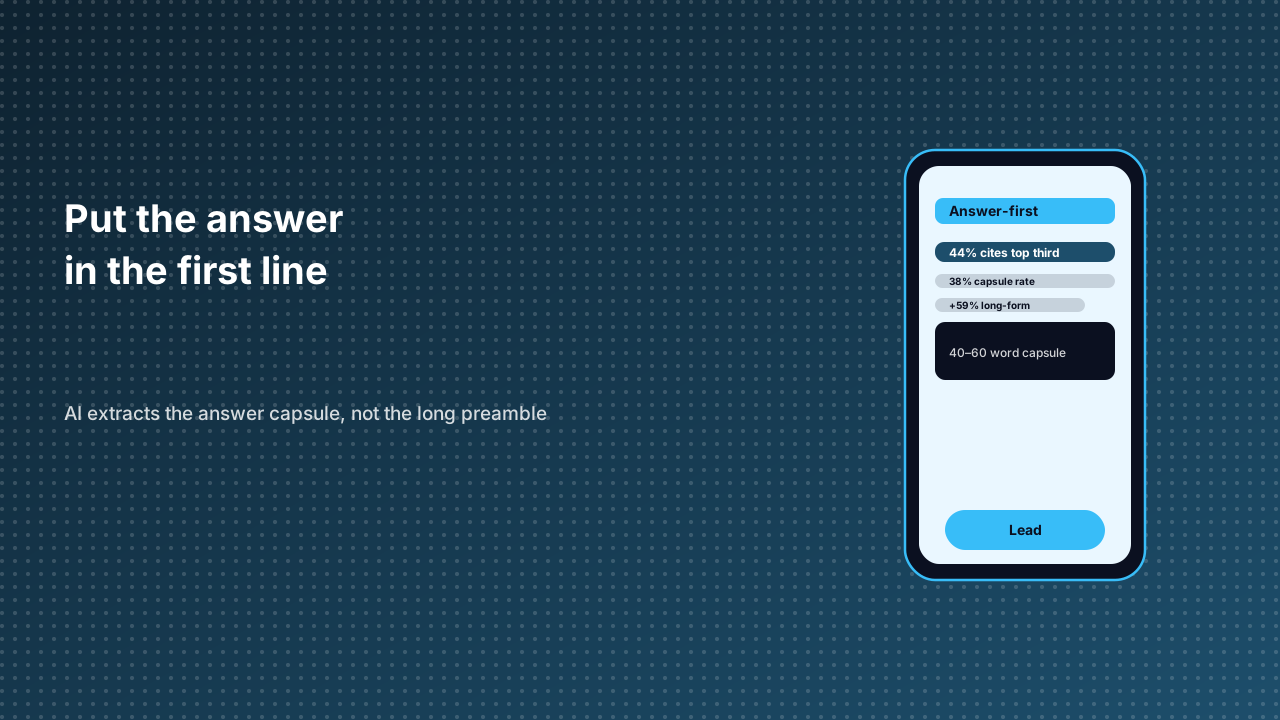
A análise de Kevin Indig sobre 18,012 citações do ChatGPT em 1.2 milhão de respostas coloca um número no padrão. 44.2% das citações de IA vinham do primeiro terço de uma página (AgentSite). A proximidade do começo não é preferência de estilo; é uma restrição de extração. Uma frase colocada no início sai mais barato para um sistema recuperar e é mais seguro de atribuir, então acaba sendo recuperada.
É por isso que grande parte dos conselhos atuais se reduz a um único movimento: transformar o título na pergunta que alguém realmente faria e respondê-la na hora. Nessa mesma linha de análise, a estrutura de título-pergunta como H2 mais uma cápsula de resposta de 40–60 palavras alcançou taxa de citação de 38% contra a linha de base. A entrada de catálogo deixa de ser um folheto e passa a ser uma unidade citável: um dado que um motor consegue repetir sem visitar a página.
O que as pesquisas realmente mediram
Cinco achados, cinco réguas diferentes e alguns números fáceis de ler demais.
| Estudo | O que foi medido | Número principal | A letra miúda |
|---|---|---|---|
| Estudo GEO de Princeton / Georgia Tech (KDD 2024, n=10,000) | Aumento de visibilidade em respostas generativas; único experimento controlado revisado por pares nesta área | Até +40% de visibilidade; estatísticas com fontes +40%, citar fontes confiáveis +37%, fluência +15%, enchimento de palavras-chave +4% | As táticas se separam bastante: encher palavras-chave quase não move a agulha |
| Kevin Indig, 2025 | 18,012 citações do ChatGPT em 1.2 milhão de respostas | 44.2% das citações do primeiro terço; título-pergunta H2 + cápsula de 40–60 palavras em 38% contra linha de base | Observacional, não um ensaio controlado |
| AirOps, 2025 | Forma dos trechos em páginas citadas pelo ChatGPT versus o primeiro resultado do Google | 13.75 trechos com listas por página citada contra menos de um; 79% usam listas HTML contra 28.6% | Associação, não receita |
| Estudos do setor (formato) | FAQ schema, hierarquia de títulos, quantidade de tabelas | Páginas com FAQ schema 3.2 vezes mais prováveis em AI Overviews; H1>H2>H3 limpo 3.2 vezes a taxa de citação; 3+ tabelas +25.7% de citações | Pesquisa setorial, métodos variados: apenas indicativo |
| SE Ranking, 2025-11 (10,000+ páginas) | Comprimento do artigo e das seções versus citação pelo ChatGPT | Artigos de 2,900+ palavras citados 59% mais que os de menos de 800; seções de 120–180 palavras 70% mais que as de menos de 50 | Um motor, um índice |
Quarenta a sessenta palavras não são uma lei física
O número é repetido como se fosse física. Não é. A cápsula de 40–60 palavras é uma convenção de trabalho entre profissionais, mais ou menos o tamanho que cabe numa caixa de resposta, e nada mais. O que o estudo GEO de Princeton/Georgia Tech estabeleceu de fato —o único experimento controlado revisado por pares aqui, na KDD 2024 com n=10,000— é que as táticas diferem muito. Estatísticas com fontes somaram 40% de visibilidade, citar fontes confiáveis 37%, a fluência 15%, enquanto o enchimento de palavras-chave conseguiu apenas 4% (spawned.com). A lição não é bater uma contagem de palavras. É dar ao extrator algo verdadeiro e com fonte que possa ser levado intacto.
E aqui está a troca desconfortável. A mesma franqueza que torna um trecho fácil de citar pode tornar um artigo desagradável de ler. Uma página montada inteiramente com pares de pergunta e cápsula se lê como uma fila de chamados: precisa, fácil de escanear e curiosamente sem alma. Os leitores continuam sendo pessoas. Chegam com perguntas pela metade e precisam de um parágrafo que ligue a resposta a uma situação antes de confiar nela. Convém estruturar o topo para a máquina e depois conquistar o leitor nos parágrafos de baixo. Enterrar a resposta falha com a máquina; achatar tudo em cápsulas falha com a pessoa. A disciplina está em saber qual parte da página faz qual trabalho.
Os números de Indig e AirOps também são observacionais. Páginas que abrem com uma resposta firme bem podem vir de equipes que também fazem bem todo o resto. A estrutura é barata de adotar e tem pouca desvantagem, então vale a pena; mas não é garantia, e quem a vende como garantia está pulando a metodologia.
Reescrever as entradas do catálogo para a extração
Num catálogo de mini-programas a mudança prática é mecânica. Cada entrada passa a ser uma pergunta que alguém realmente faria, respondida num parágrafo enxuto antes de começar a descrição mais longa. Listas substituem a prosa sempre que vários fatos ficam lado a lado: a AirOps encontrou que páginas citadas pelo ChatGPT tinham 13.75 trechos com listas em média, contra menos de um no primeiro resultado do Google, e que 79% usavam listas HTML contra 28.6% (Aruntastic). Seções de tamanho médio, entre 120 e 180 palavras, superaram as muito curtas, e páginas comparativas com três ou mais tabelas receberam 25.7% mais citações em pesquisa setorial —um número indicativo, não um resultado controlado (AEO Expert). O comprimento do artigo pesa no mesmo sentido: o índice de 10,000+ páginas da SE Ranking de 2025-11 achou que peças com mais de 2,900 palavras eram citadas 59% mais que as de menos de 800.
Nada disso quer dizer encher até um limite. O comprimento ajuda porque oferece mais superfícies citáveis a um motor, não porque a contagem de palavras seja em si um fator de ranqueamento.
Uma superfície governada
O objetivo não é escrever para máquinas às custas dos leitores. É fazer com que o primeiro parágrafo faça dois trabalhos ao mesmo tempo: responder à pergunta com clareza suficiente para ser citado e abrir uma descrição que alguém queira continuar lendo. O catálogo aberto e o ambiente de execução compartilhado da CrossMiniApp dão a um serviço uma superfície governada onde essa entrada answer-first pode ser lida, citada e lançada de qualquer lugar onde a resposta se forma. Contagens de palavras entram e saem da moda. Uma resposta clara no começo é o que permanece.