

Um operador abre o painel numa manhã de segunda-feira e encontra uma fatia fina de referências vindas de superfícies de assistente. O rastreador de posições não mostra nenhum movimento. Ainda assim, os tickets de suporte mencionam o mini app pelo nome, e as pessoas descrevem ter chegado por uma conversa e não por uma página de resultados. Nada no relatório de posições havia previsto aquilo.
Essa distância é a história real do último ano. A busca está se transformando de uma lista de links em uma resposta gerada, e a descoberta está se transformando de uma posição em uma citação. Um assistente que recomenda um mini app não o posicionou em nenhum sentido conhecido. Ele o selecionou de entre um conjunto de candidatos e o colocou dentro de uma frase. Ser selecionado funciona com mecanismos diferentes de ser posicionado, e a maioria dos manuais de distribuição ainda assume o jogo antigo.
As curvas discordam entre si
A escala da mudança aparece na cobertura antes de aparecer nos cliques. A Semrush analisou mais de dez milhões de palavras-chave e encontrou AI Overviews em aproximadamente 6.5% delas em janeiro de 2025, com um pico perto de 25% em julho e uma volta para baixo de 16% em novembro (segundo a Inc.). Uma curva que sobe, passa do ponto e recua parcialmente não é a assinatura de uma moda que se apaga. Parece mais um sistema encontrando o seu nível. O pico de julho virou manchete. O piso de novembro é o número que merece acompanhamento, porque mesmo no ponto mais baixo aproximadamente uma consulta em seis ainda produzia uma resposta gerada em vez de uma pilha neutra de links.
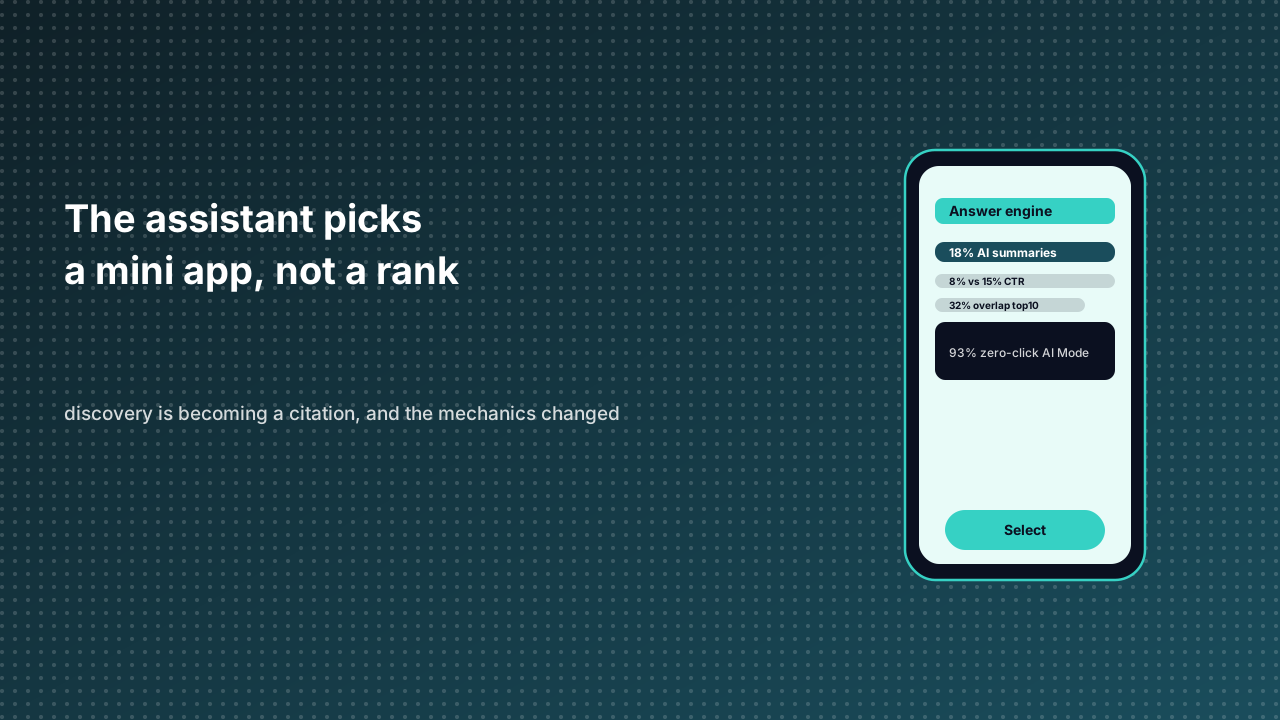
A Pew Research Center deu uma escala humana a esse piso. Em uma pesquisa com 900 adultos norte-americanos cobrindo 68,879 buscas (Pew Research Center), cerca de 18% das buscas produziram um resumo de IA. Com um resumo presente, os cliques em resultados tradicionais caíram para 8%, contra 15% sem ele. As sessões que terminaram sem nenhuma visita a site subiram para 26%, contra 16%. Consultas mais longas disparavam resumos com muito mais frequência, chegando a 53% em buscas de dez palavras ou mais. O padrão é direto: quanto mais específica a pergunta, mais provável que uma resposta seja montada para a pessoa em vez de ser buscada em uma lista.
Os números de zero-click precisam de um aviso de saúde, porque as cifras em circulação não medem a mesma coisa. No AI Mode do Google, a taxa de zero-click é de 93% no nível da sessão, contra 60% da busca tradicional e 83% das consultas com um AI Overview. Um painel multidispositivo da Semrush coloca a fatia mais ampla de zero-click perto de 59.7% em março de 2025, contra 44.2% um ano antes, com um denominador diferente, uma mistura de dispositivos diferente e uma ideia diferente do que conta como clique. A conclusão defensável é que o zero-click é alto e está crescendo sob toda definição razoável, enquanto a porcentagem exata se move conforme a superfície medida. O 93% pertence especificamente às sessões do AI Mode; é uma afirmação sobre essa superfície, não sobre toda a busca. No fim de 2025, o AI Mode havia alcançado 75 milhões de usuários ativos por dia e mais de um bilhão de consultas por mês.
Mais importante que a perda de cliques é o que fica dentro da resposta. No AI Mode, apenas 32% das URLs citadas vinham dos dez primeiros resultados do Google. Esse único número desmonta a suposição confortável de que ranquear bem e ser citado são a mesma tarefa. Dois terços das fontes que o assistente escolheu estavam fora do top ten. Uma equipe que otimiza apenas para os links azuis está refinando uma lista que o motor de resposta ignora em grande parte.
A análise da Seer Interactive do terceiro trimestre de 2025 encontrou que as marcas citadas em AI Overviews tinham taxas de cliques orgânicos 35% maiores (0.70% contra 0.52%) e taxas de cliques em anúncios pagos 91% maiores. São associações. Chamá-las de efeitos exageraria o que o estudo mostra, já que citação e cliques andam juntos em parte porque ambos derivam da demanda de marca existente. Ler os 35% como um botão a girar é como o reporting de GEO começa a parecer alquimia. O trabalho de otimização generativa de Princeton (registro de publicação), apresentado na KDD, constatou que as técnicas de GEO podiam elevar a visibilidade em respostas de motores generativos em até 40%. Esse é um teto observado em condições controladas, e qualquer catálogo que o trate como previsão está chutando. O estudo de tráfego de IA da Ahrefs serve aqui como contrapeso útil, porque acompanha quão finas ainda são essas referências em analytics comum, que é exatamente por que o reporting baseado em posições não as enxerga.
Uma tabela que vale debater
| Pergunta do operador | Manual baseado em posições | Realidade do motor de resposta |
|---|---|---|
| Onde acontece a descoberta? | Uma página ranqueada com dez links | Uma frase gerada que nomeia poucas fontes |
| O que conta como vitória? | Posição e taxa de clique | Ser citado ou recomendado dentro da resposta |
| Quão concorrido é o conjunto? | Dez vagas na primeira página | Um grupo fluido, com apenas 32% de sobreposição com o top ten |
| Os cliques acompanham a visibilidade? | Tratado como linear | Marcas citadas mostram CTR maior, apenas como correlação |
| Quão rápido muda? | Sazonal e bem estável | A cobertura oscilou de 6.5% a 25% e voltou a ficar abaixo de 16% em um ano |
A tentação de exagerar a correção
Há uma forte atração em tratar tudo isso como permissão para reescrever cada entrada do catálogo pensando nas máquinas. Isso é uma correção exagerada, e costuma produzir a papa de palavras-chave que os motores de resposta foram feitos para ignorar. O movimento útil é mais estreito e menos glamoroso: tornar a entidade inequívoca. Um identificador estável, uma descrição honesta, uma relação clara entre o serviço e sua categoria e uma abertura focada na resposta em cada entrada dão à máquina algo que ela pode citar sem adivinhar. A estrutura importa, mas a estrutura apenas entrega o produto; o produto é uma entidade clara e confiável. O verdadeiro compromisso é que escrever com a resposta primeiro pode soar direto demais para um público humano. Equipes que se importam com ambos os públicos precisam aceitar um pouco de secura em troca de serem selecionáveis. Esse é um preço que vale a pena pagar pela descoberta, mas deve ser pago de propósito, e não transformando o catálogo em um muro de perguntas frequentes.
Onde um catálogo aberto ajuda
É aqui que um catálogo aberto se justifica. Uma máquina não pode recomendar o que não consegue analisar, e não pode confiar em um registro que muda de forma de um anfitrião para outro. Um diretório compartilhado e legível por máquina dá a cada mini app uma descrição canônica que qualquer assistente pode ler, comparar e citar, enquanto um runtime compartilhado garante que o que é recomendado seja realmente aberto esteja onde estiver o anfitrião. O projeto Cross Mini App trabalha nessa combinação de catálogo aberto e runtime comum, porque ser escolhido por um motor de resposta só compensa se a recomendação chegar a uma superfície que funciona. A próxima disputa de distribuição não será travada pela posição um. Será travada por quais registros são claros o bastante para serem ditos em voz alta.


